Segmentação de Clientes com K-Means


Visão Geral
Projeto final do Módulo 33 — Modelos Avançados (Profissão Cientista de Dados). Segmenta 200 clientes de um shopping com o algoritmo de clustering K-Means a partir de idade, renda anual e Spending Score, interpreta os grupos e propõe estratégias de negócio para cada segmento.
Destaques
- 5 segmentos bem definidos: silhueta 0,555 e Davies-Bouldin 0,572
- Escolha de k validada por 4 critérios: cotovelo, silhueta, Davies-Bouldin e Calinski-Harabasz
- Dois cenários comparados (2D e 3D), com PCA para visualizar o modelo com idade
- Bloco de insights ao final de cada análise do notebook
- Ambiente reproduzível com
uve Docker
Estrutura do Projeto
customer-segmentation-kmeans/
├── data/Mall_Customers.csv
├── notebooks/segmentacao_clientes_kmeans.ipynb
├── reports/figures/          # gráficos exportados pelo notebook
├── Dockerfile / .dockerignore
├── pyproject.toml / uv.lock
└── README.md
Stack Utilizada
| Tecnologia | Função |
|---|---|
| Python 3.13 | Linguagem principal |
| pandas / NumPy | Manipulação dos dados |
| scikit-learn | K-Means, StandardScaler, PCA e métricas de cluster |
| Matplotlib / Seaborn | Visualizações |
| Jupyter | Notebook com a análise completa |
| uv / Docker | Gerenciamento de dependências e execução reproduzível |
Metodologia
- Exploração: qualidade dos dados (nulos, duplicados, faixas válidas), distribuições, outliers por IQR, análise por gênero e correlações.
- Tratamento: remoção do
CustomerID;Genderfora do modelo (binário e sem poder de diferenciação) e usado só para descrever os grupos; outliers de renda mantidos por serem plausíveis; padronização comStandardScaler. - Modelagem: K-Means com
k-means++en_init=10em dois cenários: A (Renda + Score) e B (Idade + Renda + Score). - Avaliação: k de 2 a 10 comparado por cotovelo, silhueta, Davies-Bouldin e Calinski-Harabasz, mais gráficos de silhueta por cluster.
| Cenário | k | Silhueta ↑ | Davies-Bouldin ↓ | Calinski-Harabasz ↑ |
|---|---|---|---|---|
| A: Renda + Score | 5 | 0,555 | 0,572 | 248,6 |
| B: Idade + Renda + Score | 6 | 0,428 | 0,825 | 135,1 |
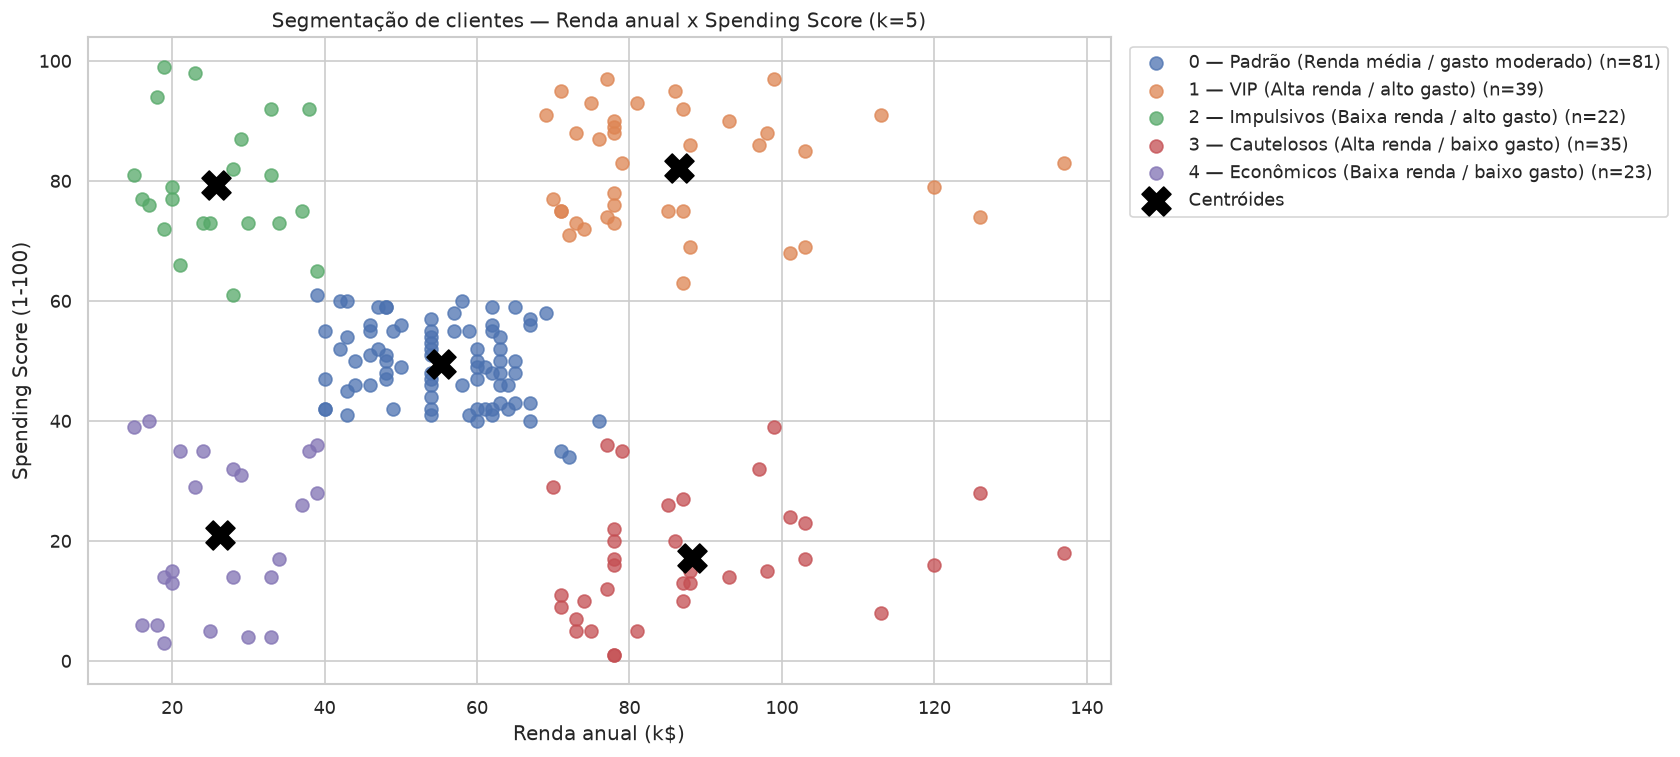
O cenário A foi escolhido como segmentação principal. O cenário B reproduz os mesmos grupos e divide o segmento "Padrão" em jovens e maduros.
Segmentos Identificados
| Segmento | Clientes | Idade média | Renda média (k$) | Score médio | Estratégia |
|---|---|---|---|---|---|
| VIP (alta renda / alto gasto) | 39 | 32,7 | 86,5 | 82,1 | Fidelidade premium e eventos exclusivos |
| Cautelosos (alta renda / baixo gasto) | 35 | 41,1 | 88,2 | 17,1 | Maior potencial: ofertas de valor e conveniência |
| Padrão (renda média / gasto moderado) | 81 | 42,7 | 55,3 | 49,5 | Campanhas de volume e cross-selling |
| Impulsivos (baixa renda / alto gasto) | 22 | 25,3 | 25,7 | 79,4 | Promoções relâmpago e fast fashion |
| Econômicos (baixa renda / baixo gasto) | 23 | 45,2 | 26,3 | 20,9 | Liquidações e cashback |
Principais insights
- A renda sozinha não explica o gasto: VIP e Cautelosos têm renda parecida e comportamento oposto.
- Clientes mais jovens gastam mais (correlação de −0,33 entre idade e score).
- O gênero praticamente não diferencia os segmentos.
- Maior valor atual nos VIP; maior potencial de crescimento nos Cautelosos.