K-Meansによる顧客セグメンテーション


概要
Profissão Cientista de Dados コース モジュール33「高度なモデル」の最終プロジェクト。 ショッピングモールの顧客200人を、年齢・年収・Spending Score をもとに K-Means クラスタリングでセグメント化し、各グループを解釈して セグメントごとのビジネス戦略を提案する。
ハイライト
- 明確に分かれた5つのセグメント:シルエット 0.555、Davies-Bouldin 0.572
- kの選択を4つの指標で検証:エルボー法、シルエット、Davies-Bouldin、Calinski-Harabasz
- 2つのシナリオ(2Dと3D)を比較し、年齢を含むモデルはPCAで可視化
- ノートブックの各分析の最後に インサイト を記載
uvと Docker による再現可能な実行環境
プロジェクト構造
customer-segmentation-kmeans/
├── data/Mall_Customers.csv
├── notebooks/segmentacao_clientes_kmeans.ipynb
├── reports/figures/          # ノートブックから出力したグラフ
├── Dockerfile / .dockerignore
├── pyproject.toml / uv.lock
└── README.md
使用技術
| 技術 | 役割 |
|---|---|
| Python 3.13 | メイン言語 |
| pandas / NumPy | データ操作 |
| scikit-learn | K-Means、StandardScaler、PCA、クラスタ評価指標 |
| Matplotlib / Seaborn | 可視化 |
| Jupyter | 分析全体をまとめたノートブック |
| uv / Docker | 依存関係管理と再現可能な実行 |
手法
- 探索的分析: データ品質(欠損値・重複・値の範囲)、分布、IQRによる外れ値、性別ごとの分析、相関。
- 前処理:
CustomerIDを除外。Genderは二値で消費行動を区別しないためモデルから除外し、グループの説明にのみ使用。年収の外れ値は妥当な値として保持。StandardScalerで標準化。 - モデリング:
k-means++、n_init=10のK-Meansを2つのシナリオで実行:A(年収+スコア)、B(年齢+年収+スコア)。 - 評価: k=2〜10をエルボー法、シルエット、Davies-Bouldin、Calinski-Harabaszで比較し、クラスタごとのシルエット図も確認。
| シナリオ | k | シルエット ↑ | Davies-Bouldin ↓ | Calinski-Harabasz ↑ |
|---|---|---|---|---|
| A:年収+スコア | 5 | 0.555 | 0.572 | 248.6 |
| B:年齢+年収+スコア | 6 | 0.428 | 0.825 | 135.1 |
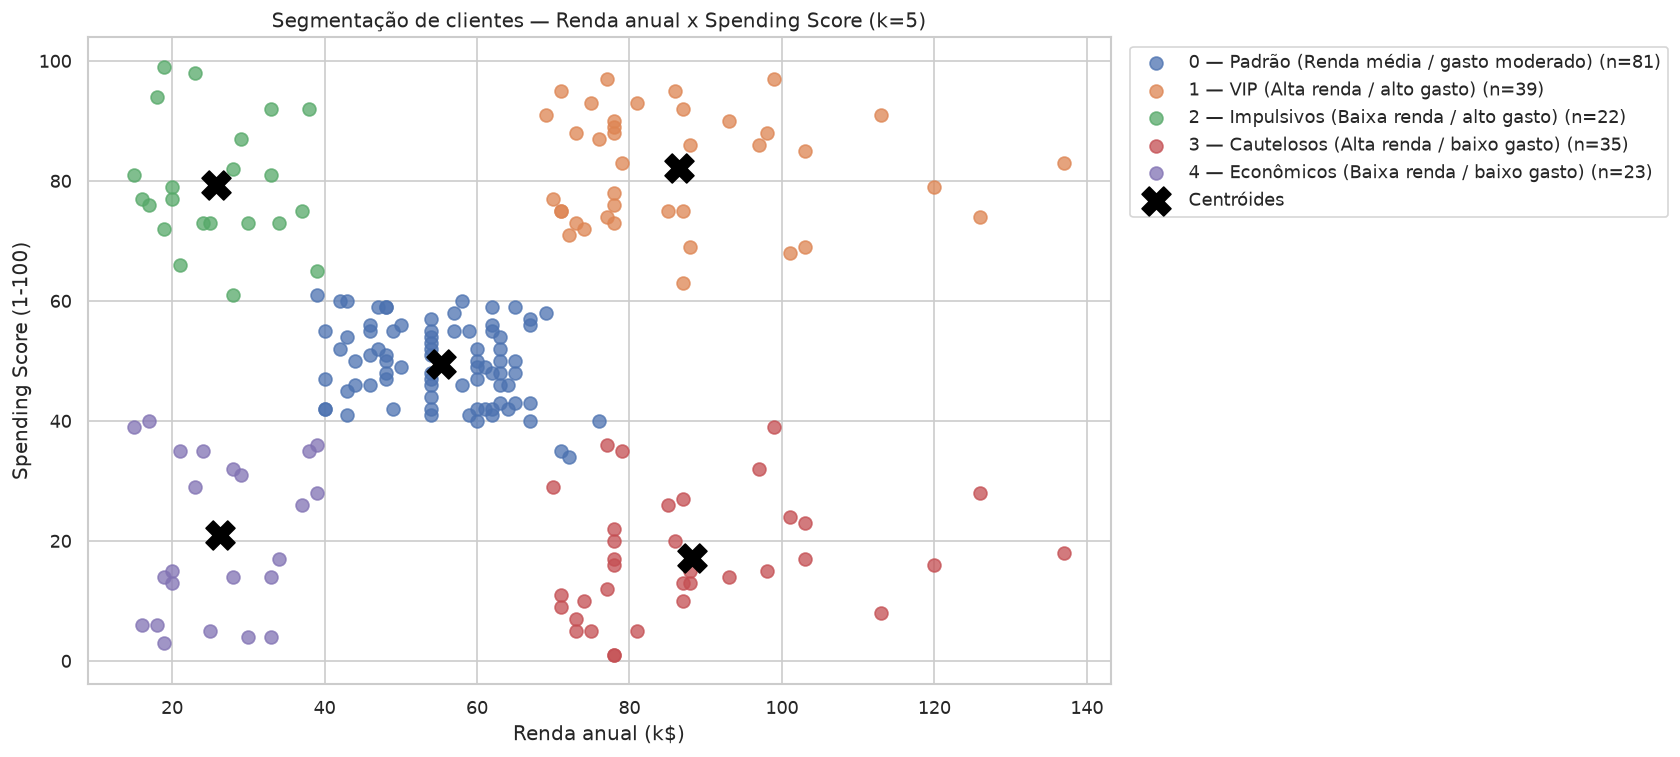
メインのセグメンテーションにはシナリオAを採用。シナリオBでも同じグループが再現され、 「標準」セグメントが若年層と熟年層に分かれる。
特定されたセグメント
| セグメント | 顧客数 | 平均年齢 | 平均年収 (k$) | 平均スコア | 戦略 |
|---|---|---|---|---|---|
| VIP(高収入・高支出) | 39 | 32.7 | 86.5 | 82.1 | プレミアム会員制度と限定イベント |
| 慎重派(高収入・低支出) | 35 | 41.1 | 88.2 | 17.1 | 最大の成長余地:価値訴求と利便性 |
| 標準(中収入・中支出) | 81 | 42.7 | 55.3 | 49.5 | ボリューム施策とクロスセル |
| 衝動派(低収入・高支出) | 22 | 25.3 | 25.7 | 79.4 | タイムセールとファストファッション |
| 節約派(低収入・低支出) | 23 | 45.2 | 26.3 | 20.9 | セールとキャッシュバック |
主なインサイト
- 年収だけでは支出を説明できない:VIPと慎重派は年収が近いが行動は正反対。
- 若い顧客ほど支出が多い(年齢とスコアの相関 −0.33)。
- 性別はセグメント間でほとんど差がない。
- 現在の価値が最も高いのは VIP、成長余地が最も大きいのは 慎重派。
実行方法
Note
ノートブックと分析はポルトガル語で書かれています。