タイタニック — モデル最終決戦




概要
Profissão Cientista de Dados コース モジュール41のプロジェクト。 Kaggleコンペティション Titanic: Machine Learning from Disaster へのソリューションを、エンジニアリングプロジェクトとして構築:テスト済みのPythonパッケージ、 データリークのないパイプライン、再現可能な実験、Docker環境。
| 最終モデル | CV精度 (5×3) | Kaggleスコア |
|---|---|---|
| ハード投票(LogReg + SVM + Random Forest + XGBoost) | 0.8503 | 0.77751 |
ハイライト
- リークのないグループ生存特徴量: leave-one-outを用いたscikit-learnトランスフォーマーで、各fold内で再計算。これだけでロジスティック回帰が0.8294から0.8440に向上
- 厳密な検証:
RepeatedStratifiedKFold(5×3)、foldごとの対応比較、探索と評価で別々のシード - 結果を見る前に判断基準を定義: クラス不均衡対策とwoman-child-groupルールを検証し、根拠に基づいて不採用
- エンドツーエンドで再現可能: 依存関係のロック、固定シード、Docker — コンテナはローカルの指標を小数点第4位まで再現
- コード品質: 65件のテスト、ruff、pre-commit、Conventional Commits
プロジェクト構造
titanic-duelo-final/
├── data/                  # raw、processed、submissions
├── models/                # 学習済みモデル .joblib
├── notebooks/
│   ├── 01_eda.ipynb                                   # 探索的データ分析
│   └── MOD41_EXERCICIO_DUELOFINAL_Renan_Toyoyama.ipynb  # 提出用ノートブック
├── reports/               # 各実験の結果と図
├── src/titanic/           # features, transformers, models, evaluate,
│                          # tuning, ensemble, predict...
├── tests/                 # 65件のテスト (pytest)
├── Dockerfile / Makefile
├── pyproject.toml
└── requirements.lock
プロジェクトの基本ルール:データから学習する統計量はすべてパイプライン内に置く。 行単位で完結する特徴量(Title、FamilySize、Deck)は事前に計算し、 欠損値補完・スケーリング・グループ生存率は各fold内で学習する。
使用技術
| 技術 | 役割 |
|---|---|
| Python 3.11 | メイン言語 |
| pandas | データ操作と特徴量エンジニアリング |
| scikit-learn | パイプライン、カスタムトランスフォーマー、CV、チューニング、アンサンブル |
| XGBoost | 勾配ブースティングモデル |
| imbalanced-learn | クラス不均衡対策の実験(SMOTE) |
| Matplotlib / Seaborn | 可視化 |
| pytest / ruff / pre-commit | テストとコード品質 |
| Docker / Make / Kaggle CLI | 再現可能な実行、データ取得、提出 |
手法
- 意思決定につながるEDA: 性別と客室クラスが支配的。敬称は性別・年齢・社会的地位を要約。同じチケットのグループは生死を共にする傾向。客室情報の欠損自体が情報になる。
- 特徴量:
Title、FamilySize/FamilyBand、Deck/HasCabin、TicketGroupSize、FarePerPerson、敬称ごとの中央値で補完したAge、group_survival(leave-one-out)。 - 前処理: 欠損値補完、運賃への
log1p、StandardScaler(線形モデル/SVMのみ)、one-hotエンコーディングを含むColumnTransformer。 - 検証:
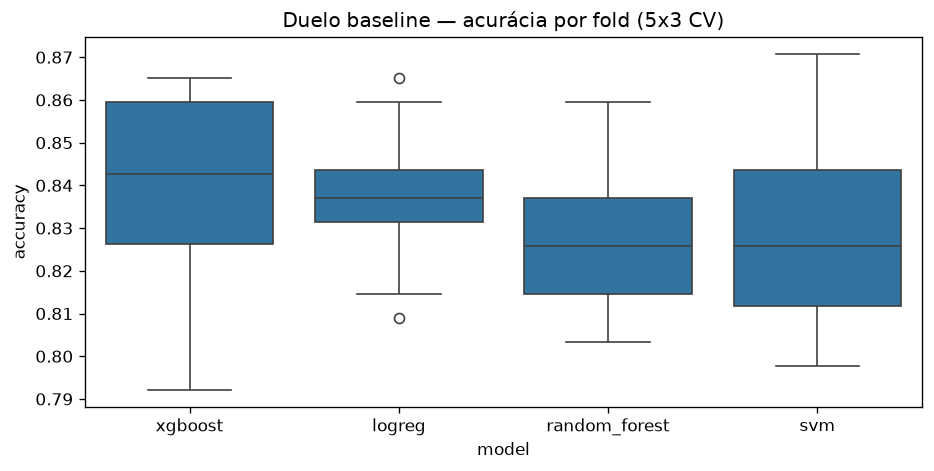
RepeatedStratifiedKFold5×3 — 単一の5分割では0.7ポイントのばらつきがあった。 - クラス不均衡対策: なし ×
class_weight× SMOTE。4モデル中3モデルで「対策なし」が勝利。 - チューニング:
GridSearchCV(LogReg、SVM)とRandomizedSearchCV(RF、XGBoost)。別シードで再評価し、XGBoostに0.77ポイントの楽観バイアスを確認。 - アンサンブル: out-of-fold誤差の相関から2つのファミリー(線形系と木系)を確認。ハード投票が勝利。
結果
プロジェクトの推移
| 段階 | モデル | CV精度 | Kaggle |
|---|---|---|---|
| 参照 | 「女性のみ生存」 | — | ~0.766 |
| ベースライン | ロジスティック回帰(デフォルト) | 0.8373 | — |
| チューニング | チューニング済みRandom Forest | 0.8485 | 0.77751 |
| アンサンブル | ハード投票 | 0.8503 | 0.77751 |
最終決戦
| モデル | 精度 | 標準偏差 | ROC AUC | 対RF勝率 |
|---|---|---|---|---|
| ハード投票 | 0.8503 | 0.0156 | — | 67% |
| チューニング済みRandom Forest | 0.8485 | 0.0183 | 0.8894 | — |
| スタッキング | 0.8444 | 0.0188 | 0.8930 | 33% |
| ソフト投票 | 0.8440 | 0.0167 | 0.8940 | 33% |
うまくいかなかった実験
| 実験 | 結果 | 理由 |
|---|---|---|
SMOTE と class_weight |
4モデル中3モデルで精度低下 | 閾値が少数クラス側にずれ、62/38の比率では正解より誤りが増える |
| スタッキングとソフト投票 | AUCは最高、精度は最低 | 確率の平均化で値が中央に寄り、境界付近の乗客の予測が反転する |
| woman-child-groupルール | 勝率7〜33% | 冗長:group_survival + Title + Sex がすでにパターンを捉えていた |
学んだこと
- データから学習する統計量はすべて パイプライン内 に置く。
- 平均の差は本当の差ではない:XGBoostはベースラインで「首位」だったが、勝ったのはfoldの40%のみ。
- 探索のベストスコアは 楽観的。別シードでの再評価がそのバイアスを測る。
- 最良のモデルは 指標によって変わる:AUCの首位は精度で最下位だった。
- CVは推定であって約束ではない:CVの0.85はKaggleで0.78になった。
実行方法
前提条件
Kaggleトークンを ~/.kaggle/access_token に保存し、タイタニックのページで
Join Competition からコンペティションのルールに同意しておくこと。
主なターゲット:make baseline、make balance、make tune、make ensemble、
make wcg、make predict、make submit。
Note
ノートブックとドキュメントはポルトガル語で書かれています。