Titanic — Duelo Final de Modelos




Visão Geral
Projeto do Módulo 41 (Profissão Cientista de Dados). Solução para a competição Titanic: Machine Learning from Disaster do Kaggle, construída como um projeto de engenharia: pacote Python testado, pipelines sem vazamento de dados, experimentos reproduzíveis e ambiente em Docker.
| Modelo final | Acurácia CV (5×3) | Score no Kaggle |
|---|---|---|
| Votação hard (LogReg + SVM + Random Forest + XGBoost) | 0.8503 | 0.77751 |
Destaques
- Feature de sobrevivência do grupo sem vazamento: transformer scikit-learn com leave-one-out, recalculado dentro de cada fold. Sozinha, levou a regressão logística de 0.8294 para 0.8440
- Validação rigorosa:
RepeatedStratifiedKFold(5×3), comparação pareada fold a fold e seeds separadas para busca e avaliação - Critérios de decisão definidos antes dos resultados: balanceamento e regra woman-child-group testados e descartados com base em evidência
- Reprodutível de ponta a ponta: lock de dependências, seeds fixas e Docker — o container reproduz as métricas locais até a 4ª casa decimal
- Qualidade de código: 65 testes, ruff, pre-commit e Conventional Commits
Estrutura do Projeto
titanic-duelo-final/
├── data/                  # raw, processed e submissions
├── models/                # modelos treinados .joblib
├── notebooks/
│   ├── 01_eda.ipynb                                   # análise exploratória
│   └── MOD41_EXERCICIO_DUELOFINAL_Renan_Toyoyama.ipynb  # notebook de entrega
├── reports/               # resultados de cada experimento + figuras
├── src/titanic/           # features, transformers, models, evaluate,
│                          # tuning, ensemble, predict...
├── tests/                 # 65 testes (pytest)
├── Dockerfile / Makefile
├── pyproject.toml
└── requirements.lock
A regra central do projeto: toda estatística aprendida dos dados fica dentro do pipeline. Features que só transformam a própria linha (Title, FamilySize, Deck) são calculadas antes; imputação, escala e sobrevivência do grupo são ajustadas em cada fold.
Stack Utilizada
| Tecnologia | Função |
|---|---|
| Python 3.11 | Linguagem principal |
| pandas | Manipulação dos dados e feature engineering |
| scikit-learn | Pipelines, transformers customizados, CV, tuning e ensembles |
| XGBoost | Modelo de gradient boosting |
| imbalanced-learn | Experimento de balanceamento (SMOTE) |
| Matplotlib / Seaborn | Visualizações |
| pytest / ruff / pre-commit | Testes e qualidade de código |
| Docker / Make / Kaggle CLI | Execução reproduzível, download de dados e submissão |
Metodologia
- EDA orientada a decisões: sexo e classe dominam; o título resume sexo, idade e status; grupos de ticket tendem a sobreviver ou morrer juntos; faltar cabine já é informação.
- Features:
Title,FamilySize/FamilyBand,Deck/HasCabin,TicketGroupSize,FarePerPerson,Ageimputada pela mediana do título egroup_survival(leave-one-out). - Pré-processamento:
ColumnTransformercom imputação,log1pna tarifa,StandardScaler(só para modelos lineares/SVM) e one-hot. - Validação:
RepeatedStratifiedKFold5×3 — uma única divisão em 5 folds variava 0,7 p.p. - Balanceamento: nenhum ×
class_weight× SMOTE. Não balancear venceu em 3 de 4 modelos. - Tuning:
GridSearchCV(LogReg, SVM) eRandomizedSearchCV(RF, XGBoost), reavaliado com outra seed — revelou 0,77 p.p. de otimismo no XGBoost. - Ensembles: correlação dos erros out-of-fold mostrou duas famílias (lineares e árvores); votação hard venceu.
Resultados
Evolução do projeto
| Etapa | Modelo | Acurácia CV | Kaggle |
|---|---|---|---|
| Referência | "Só mulheres sobrevivem" | — | ~0.766 |
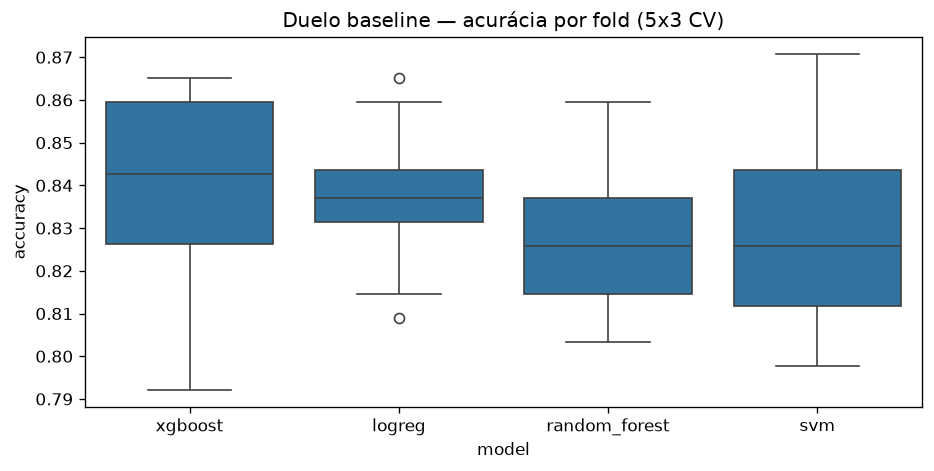
| Baseline | Regressão logística, parâmetros padrão | 0.8373 | — |
| Tuning | Random Forest tunado | 0.8485 | 0.77751 |
| Ensemble | Votação hard | 0.8503 | 0.77751 |
Duelo final
| Modelo | Acurácia | Desvio | ROC AUC | Win rate vs RF |
|---|---|---|---|---|
| Votação hard | 0.8503 | 0.0156 | — | 67% |
| Random Forest tunado | 0.8485 | 0.0183 | 0.8894 | — |
| Stacking | 0.8444 | 0.0188 | 0.8930 | 33% |
| Votação soft | 0.8440 | 0.0167 | 0.8940 | 33% |
Experimentos que não funcionaram
| Experimento | Resultado | Por quê |
|---|---|---|
SMOTE e class_weight |
Pioraram a acurácia em 3 de 4 modelos | Deslocam o limiar a favor da classe minoritária; com 62/38 isso gera mais erros que acertos |
| Stacking e votação soft | Melhor AUC, pior acurácia | Combinar probabilidades puxa os valores para o meio e passageiros na fronteira mudam de lado |
| Regra woman-child-group | Win rate de 7–33% | Redundante: group_survival + Title + Sex já capturavam o padrão |
Lições aprendidas
- Toda estatística aprendida dos dados vai dentro do pipeline.
- Diferença na média não é diferença real: o XGBoost "liderou" o baseline vencendo só 40% dos folds.
- O melhor score de uma busca é otimista; reavaliar com outra seed mede esse viés.
- O melhor modelo depende da métrica: o campeão em AUC foi o último em acurácia.
- A CV é uma estimativa, não uma promessa: 0.85 na CV virou 0.78 no Kaggle.
Como Executar
Pré-requisitos
Token do Kaggle salvo em ~/.kaggle/access_token e regras da competição
aceitas em Join Competition na página do Titanic.
Principais alvos: make baseline, make balance, make tune, make ensemble,
make wcg, make predict e make submit.